O problema
Mercados financeiros não se comportam do mesmo jeito o tempo todo. Uma estratégia que funciona numa alta tranquila pode falhar feio numa reversão volátil, e a diferença entre esses estados nem sempre é óbvia enquanto você está dentro de um deles. As ferramentas usuais ou assumem que os retornos são normalmente distribuídos — não são — ou reduzem o mercado a um único binário, alta ou baixa, que esconde a maior parte do que importa.
Eu queria uma forma de caracterizar o estado atual de uma série em mais de um eixo, com uma medida honesta de quão confiante é essa caracterização.
A abordagem
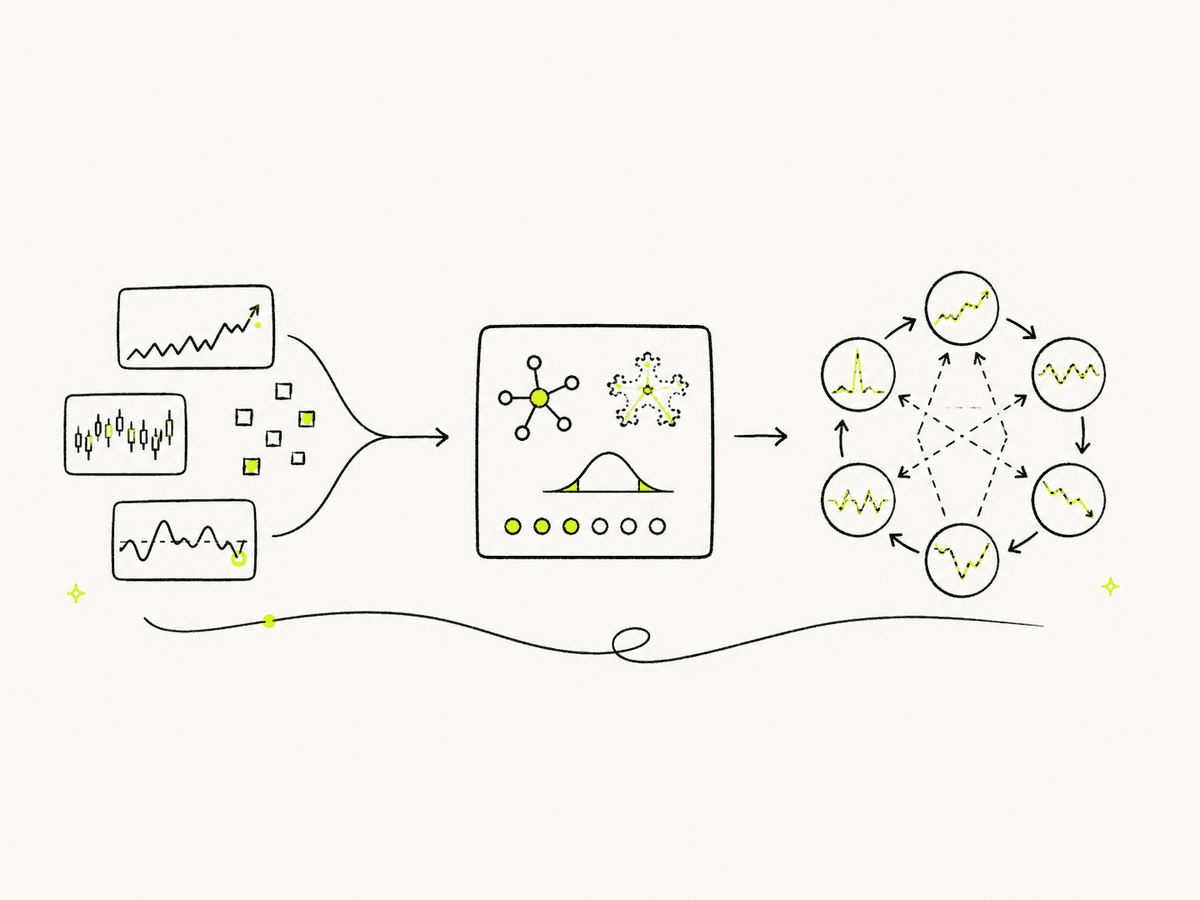
O toolkit classifica uma série em seis regimes — alta, baixa e lateral, cada um calmo ou volátil — a partir de um conjunto de indicadores complementares:
- Análise de tendência e volatilidade para posicionar a série nos dois eixos principais.
- Expoente de Hurst e features fractais para distinguir comportamento de tendência persistente de reversão à média. É daí que vem o nome: Julia e Mandelbrot estudaram autossimilaridade, e o comportamento de mercado se repete entre janelas de tempo de uma forma que curvas normais não capturam.
- Diagnósticos de risco de cauda — CVaR, VaR, índice de cauda de Hill, curtose e drawdown — porque as falhas interessantes moram nas caudas.
- Pertinência fuzzy em vez de cortes rígidos, de modo que uma série na fronteira entre dois regimes é reportada como genuinamente ambígua em vez de forçada em um deles.
- Matrizes de transição de Markov para medir como os regimes persistem e no que tendem a se transformar.
Vem como um pacote Python de verdade, com uma CLI que detecta a fonte de dados automaticamente, um conjunto de colunas de warmup e de sinal válido para que as linhas iniciais possam ser filtradas com clareza, e visualizações de preço junto da evolução dos indicadores e dos regimes.
O que ele deliberadamente não faz
A biblioteca produz colunas de indicadores. Ela não define entradas, saídas, dimensionamento de posição ou limites de risco, e não faz nenhuma alegação de prever retornos. Essa fronteira é intencional: classificação de regime é uma entrada para um processo de decisão, não a decisão em si, e ferramentas que embaralham as duas coisas costumam receber mais confiança do que merecem.
Resultado
O projeto é open source e mantido ativamente, com suíte de testes e uma CLI documentada. A análise de retornos futuros é diagnóstico de pesquisa — uma forma de checar como os regimes de fato se comportaram historicamente, e não um backtest fantasiado de resultado.