O problema
Na Prevision, montar uma lista de prospecção significava alguém sentado com uma planilha e um navegador, buscando empresas uma a uma, copiando endereços e contatos à mão. Era lento, era inconsistente entre as pessoas que faziam, e os dados resultantes tinham exatamente a qualidade que se espera de digitação manual repetitiva.
O gargalo não era esforço. Era que o trabalho era estruturalmente repetitivo, o que significa que ele não deveria estar sendo feito por uma pessoa.
A abordagem
Dividi o problema em duas etapas, cada uma um pequeno programa em Python que faz uma coisa só.
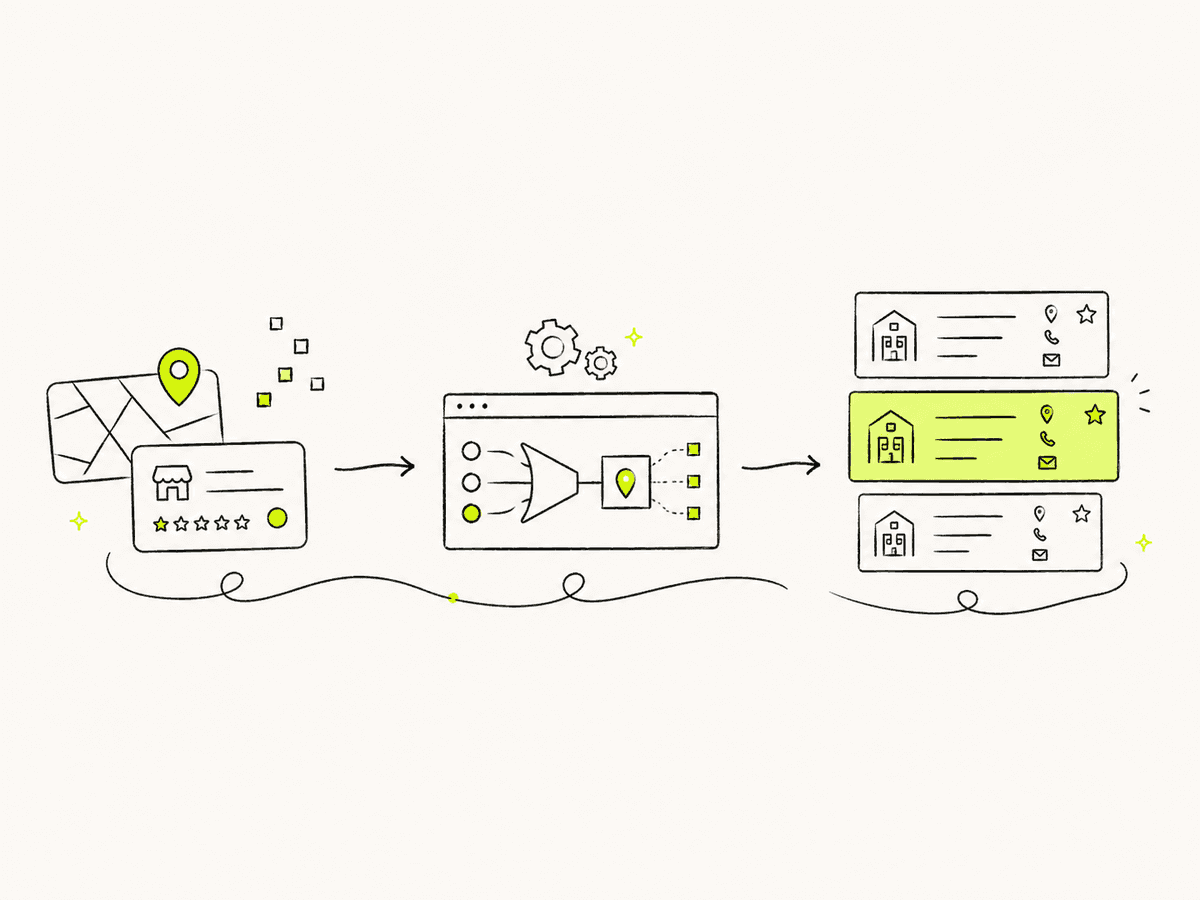
Etapa um — resolução de endereços. Lê uma planilha com nomes de empresas, consulta a API do Google Maps para cada uma, e devolve uma planilha com endereços resolvidos e identificadores de local. Construída sobre pandas, para que entrada e saída permaneçam no formato com que o time comercial já trabalhava.
Etapa dois — enriquecimento e descoberta. Pega esses endereços resolvidos e busca, dentro de um raio configurável, empresas do segmento-alvo, retornando nome, site, endereço formatado e avaliação. É a etapa que transforma uma lista conhecida em uma lista qualificada maior, porque encontra empresas que ninguém tinha pensado em buscar.
Manter as etapas separadas importava. Resolução de endereço é barata e idempotente; a busca por raio é a chamada cara. Separar significava que a etapa dois podia ser reexecutada com raios ou segmentos diferentes sem pagar de novo pela etapa um.
Resultado
O tempo de pesquisa manual caiu por volta da metade, e a base de prospecção cresceu de forma substancial — não porque alguém trabalhou mais, mas porque o espaço de busca se expandiu além do que a pesquisa manual conseguia cobrir. A qualidade dos dados melhorou como efeito colateral: endereços vindos de API são consistentes de um jeito que endereços copiados à mão não são.
As duas etapas são open source.